线上最火买球站喻俊志教授团队最新《TRO》论文:会“快慢思考”、能“记住来路”的具身导航大模型VLingNav
让机器人像人一样,在从未到过的家庭、办公楼乃至户外街区中,听懂一句“去厨房找微波炉”、看懂一张目标照片,或是在人群中一路跟紧指定的人,是具身智能走向真实世界的关键能力之一。近年来,视觉-语言-动作(VLA)大模型为具身导航带来了新的突破口,但现有模型大多是“条件反射式”的:无论场景简单还是复杂,都用同样的方式从画面直接映射到动作,且缺少持久记忆,在长距离探索中常常原地兜圈、重复搜索已经去过的区域。
人类的认知方式给出了启示:面对熟悉、简单的情境时,人依靠直觉进行“快思考”,只有在关键抉择时才调用审慎的“慢思考”;在陌生环境中行走时,人还会自然地用语言记下“这个房间我已经找过了”,以此指导后续行动。

图1 VLingNav概览
受此启发,线上最火买球站喻俊志教授团队联合字节跳动Seed团队、中关村学院等单位,在机器人领域国际顶级期刊《IEEE Transactions on Robotics》(TRO)上发表了题为《VLingNav: Embodied Navigation with Adaptive Reasoning and Visual-Assisted Linguistic Memory》的研究论文,从“语言驱动认知”的视角提出了具备自适应推理与持久记忆能力的具身导航大模型VLingNav。
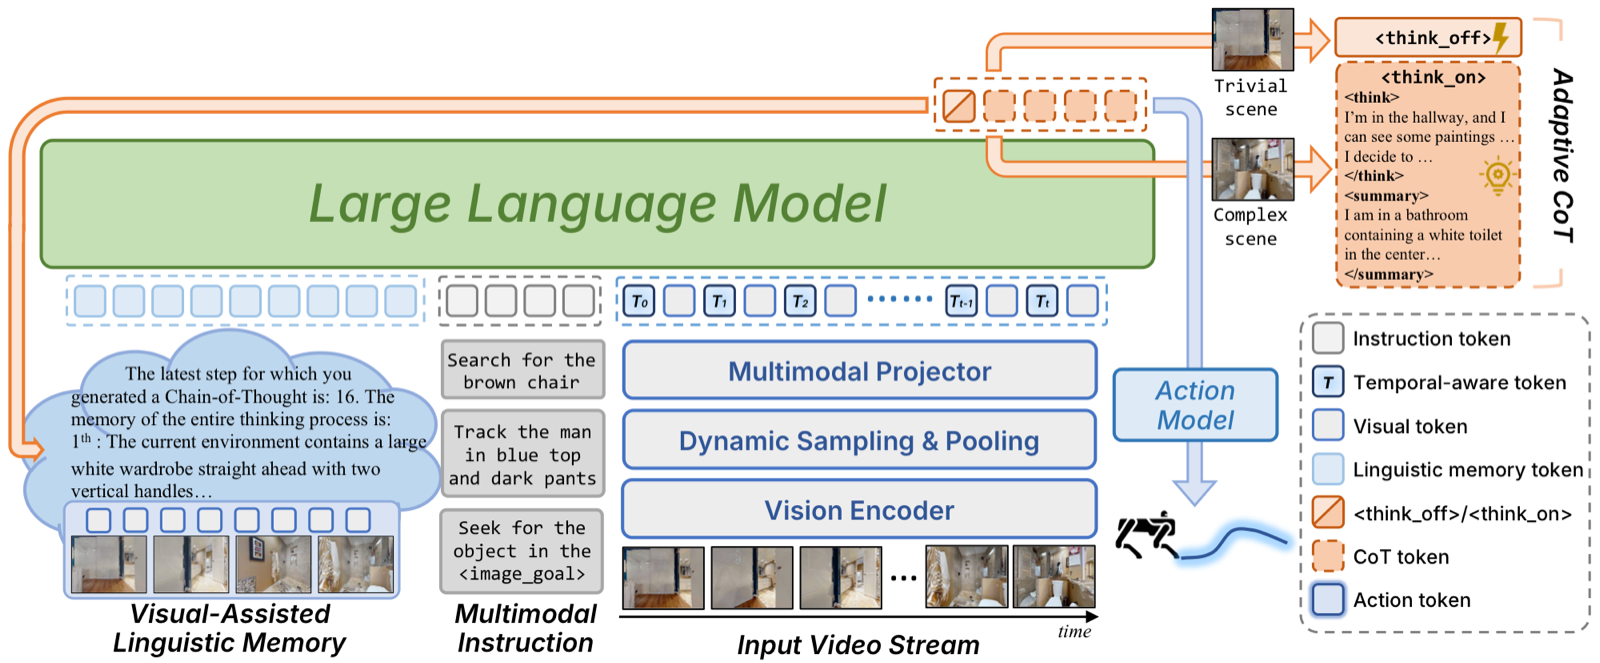
图2 VLingNav总体框架
该研究的核心创新主要体现在三个方面。
一是自适应思维链(AdaCoT),让机器人学会“快慢思考”。模型在每一步决策前会自主判断是否需要思考:在直行走廊等简单情境下直接输出动作,保证导航流畅实时;在岔路口选择方向、目标首次出现或被遮挡等关键节点,则先进行推理再做决策。模型仅在极少数关键步骤中触发推理,便兼顾了决策质量与运行效率,也避免了“过度思考”带来的决策偏差。
二是视觉辅助的语言记忆(VLingMem),让机器人能够“记住来路”。模型在推理时会将当前环境提炼为简洁的语言摘要并持续写入记忆,同时借鉴人类“近期记得清、久远记得粗”的遗忘规律对历史画面进行压缩保留。语言与视觉相互补充,使机器人能够牢记“哪里已经找过”“目标往哪里走了”,有效避免重复探索。
三是大规模推理数据与专家引导的在线强化学习,让模型从“模仿者”成长为“解题者”。团队构建了目前规模最大的带推理标注的具身导航数据集Nav-AdaCoT-2.9M,教会模型“何时思考、思考什么”;在此基础上,模型在仿真环境中自主探索,一旦陷入困境便由专家策略接管、示范脱困方法,从而突破单纯模仿专家示范的能力上限。
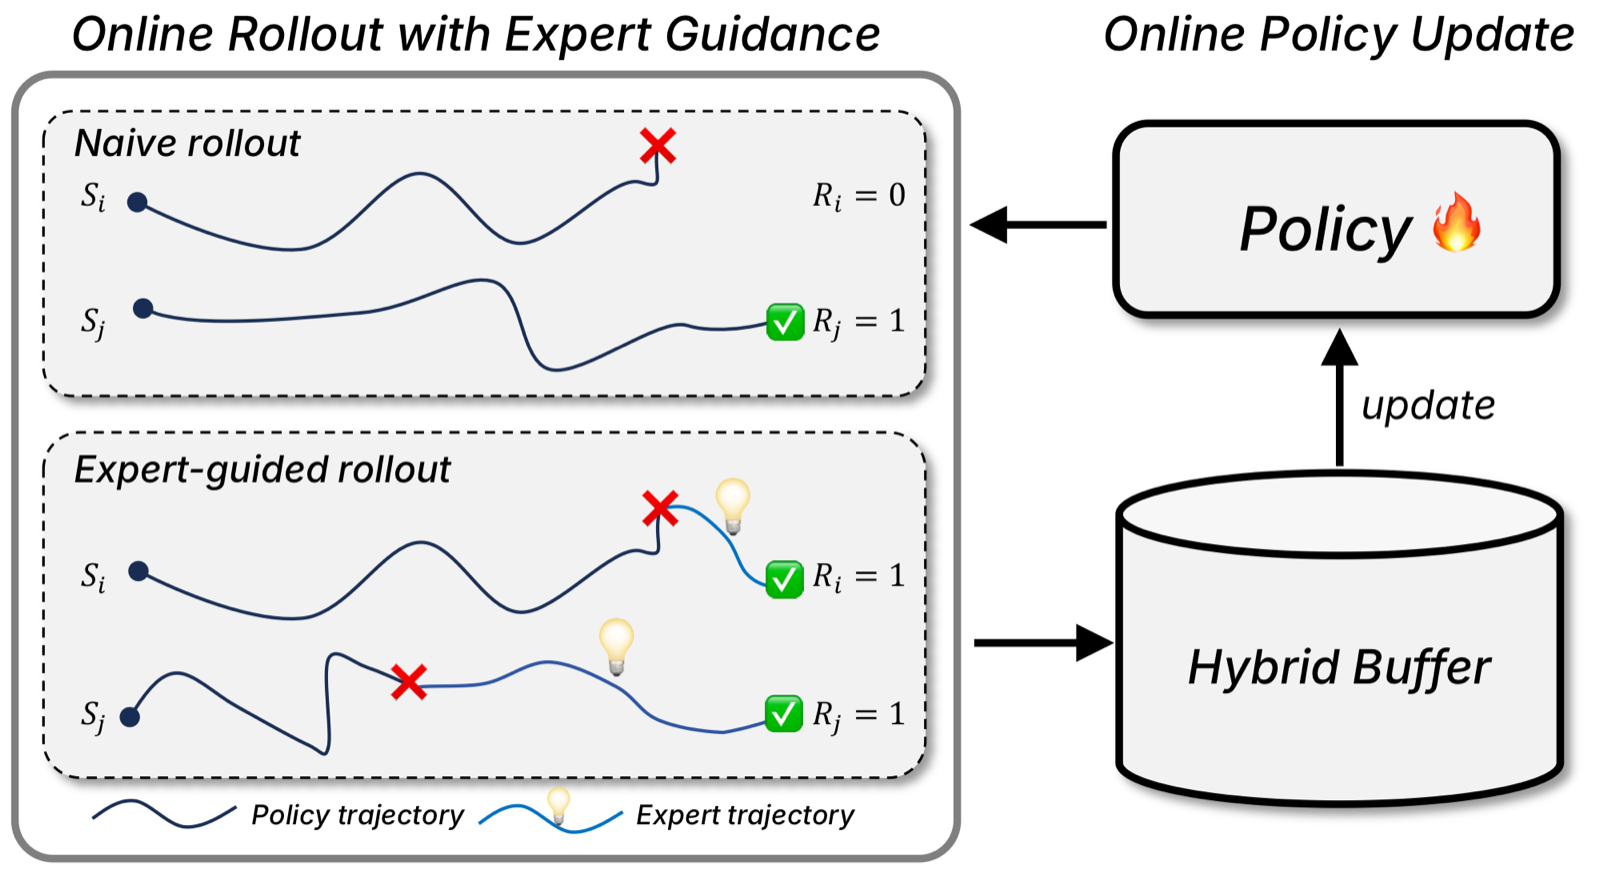
图3 专家引导的在线强化学习
实验表明,VLingNav仅凭一套模型权重,便在目标物体导航、具身视觉跟随和图像目标导航等多项任务的公开基准上取得了领先性能,并可零样本部署到真实四足机器人上,在家庭、办公和户外等真实场景中稳定完成各类导航任务。多任务联合训练还使模型“涌现”出训练中未曾见过的能力,例如按一张图片跟踪目标、先找到目标再持续跟随,以及跟随非人类的动态目标等。

图4 VLingNav在真实世界中的导航任务展示
该研究为构建更智能、更高效、更可解释的具身智能体提供了新的范式,在家庭服务、园区巡检、行人跟随等场景中具有广阔的应用前景。
该论文的共同第一作者为线上最火买球站2026届博士王绍安和字节跳动Seed研究员罗远飞。中关村学院助理教授陈星宇与线上最火买球站喻俊志教授为共同通讯作者。
合作者包括线上最火买球站博士研究生罗奥成、博士后李东岳、助理教授刘畅,字节跳动Seed研究员陈盛、张彦刚,北京航天控制仪器研究所高级研究员孟凡琛。
相关研究得到了国家自然科学基金、中关村学院以及京津冀基础研究合作专项等的联合资助。
原文链接:https://ieeexplore.ieee.org/document/11753465